Искусственный интеллект и статистика больших данных: тренды 2026
2026-08-16
- Искусственный интеллект и статистика больших данных: синтез технологий для промышленной эффективности в 2026 году
- Эволюция взаимодействия: от описательной аналитики к когнитивным цифровым двойникам
- Математические основы: как статистика питает искусственный интеллект
- Применение в отраслях: от нефтегаза до дискретного производства
- Сравнительный анализ подходов: Классическая статистика vs Машинное обучение
- Типичные ошибки при внедрении и как их избежать
- Как выбрать поставщика решений: критерии оценки в 2026 году
- Практическая реализация: опыт ООО «Хэнань Цзюйхэ Текнолоджи»
- Перспективы развития: что ждать в ближайшем будущем
- FAQ: Часто задаваемые вопросы
- Заключение и рекомендации по началу работы
Искусственный интеллект и статистика больших данных: синтез технологий для промышленной эффективности в 2026 году
Искусственный интеллект и статистика больших данных в 2026 году представляют собой не просто набор IT-инструментов, а фундаментальный технологический стек для управления сложными производственными системами. В условиях Industry 4.0 и перехода к Industry 5.0, связка ИИ (AI) и Big Data позволяет предприятиям переходить от реактивного обслуживания к предиктивному, оптимизировать цепочки поставок в реальном времени и снижать энергопотребление на 15–25%. Ключевая ценность заключается в способности алгоритмов машинного обучения выявлять скрытые паттерны в терабайтах неструктурированных данных с датчиков IoT, журналов событий и ERP-систем, превращая «шум» в измеримые инженерные решения.
Для технических директоров и главных инженеров понимание того, как искусственный интеллект и статистика больших данных взаимодействуют на уровне архитектуры предприятия, становится критическим навыком. Это не вопрос выбора между облачными сервисами или локальными серверами; это вопрос интеграции семантических моделей с физическими процессами. В данной статье мы разберем технические аспекты внедрения, математические основы обработки массивов данных и практические кейсы, демонстрирующие ROI от внедрения интеллектуальных систем аналитики в тяжелом машиностроении, энергетике и логистике.
Эволюция взаимодействия: от описательной аналитики к когнитивным цифровым двойникам
Еще пять лет назад большинство промышленных решений ограничивались дашбордами, показывающими текущее состояние оборудования. Сегодня ландшафт изменился. Искусственный интеллект и статистика больших данных эволюционировали в систему, способную не только описывать прошлое, но и симулировать будущее. Центральным элементом этой трансформации стал концепт «Когнитивного цифрового двойника» (Cognitive Digital Twin).
В отличие от статических 3D-моделей, когнитивный двойник непрерывно обучается на потоке данных. Он использует рекуррентные нейронные сети (RNN) и механизмы внимания (Transformers) для анализа временных рядов. Например, вибрация подшипника турбины, температура масла и нагрузка на вал анализируются не изолированно, а в контексте исторических данных за 10 лет эксплуатации. Статистика больших данных обеспечивает очистку и нормализацию этих входных параметров, устраняя выбросы, вызванные сбоями датчиков, в то время как ИИ строит вероятностную модель отказа.
В 2026 году мы наблюдаем смещение фокуса с централизованной обработки на периферийные вычисления (Edge AI). Передача всех сырых данных в облако становится экономически нецелесообразной из-за затрат на пропускную способность и задержек (latency). Поэтому предварительная статистическая обработка и базовые выводы ИИ происходят непосредственно на контроллерах оборудования, а в центральное хранилище отправляются только агрегированные инсайты и аномалии.
Архитектурные компоненты современного стека Big Data + AI
Для успешной реализации проектов необходимо понимать слоистую структуру инфраструктуры:
- Слой сбора данных (Data Ingestion): Использование протоколов MQTT, OPC UA и Modbus TCP для унификации потоков от разнородного оборудования. Важным аспектом является обеспечение целостности данных при передаче через промышленные шлюзы.
- Слой хранения (Data Lakehouse): Гибридные архитектуры, сочетающие гибкость Data Lakes для неструктурированных данных (видео, аудио, логи) и строгость Data Warehouses для транзакционной информации. Форматы Apache Parquet и Delta Lake становятся стандартом де-факто благодаря эффективности сжатия и скорости чтения.
- Слой обработки и Feature Engineering: Здесь применяется статистика больших данных для создания признаков (features). Инженеры данных выделяют такие параметры, как скользящее среднее вибрации, спектральная плотность мощности или корреляция между давлением и температурой.
- Слой моделей (Model Serving): Развертывание обученных моделей (Random Forest, Gradient Boosting, Deep Neural Networks) в контейнерах Docker/Kubernetes для масштабируемого инференса.
Математические основы: как статистика питает искусственный интеллект
Многие закупщики и менеджеры ошибочно полагают, что ИИ — это «черный ящик», работающий сам по себе. На самом деле, качество любой модели машинного обучения напрямую зависит от качества статистической подготовки данных. Искусственный интеллект и статистика больших данных неразрывны: статистика предоставляет язык для описания реальности, а ИИ — инструмент для нахождения в этом описании сложных нелинейных зависимостей.
Рассмотрим ключевые статистические методы, лежащие в основе промышленных AI-решений 2026 года:
- Байесовский вывод (Bayesian Inference): Позволяет обновлять вероятность гипотезы по мере поступления новых данных. В контексте прогнозирования отказов это означает, что модель начинает с априорного распределения (на основе паспортных данных оборудования) и корректирует прогноз риска поломки в реальном времени, учитывая фактические условия эксплуатации.
- Анализ главных компонент (PCA): Критически важен для снижения размерности данных. Промышленный станок может генерировать 500+ параметров в секунду. PCA позволяет сократить это количество до 10–15 наиболее информативных векторов, удаляя мультиколлинеарность и шум, что значительно ускоряет обучение моделей без потери точности.
- Кластеризация (K-Means, DBSCAN): Используется для сегментации режимов работы оборудования. Алгоритм автоматически выявляет, что станок работает в «штатном», «перегруженном» или «холостом» режиме, даже если эти режимы не были явно запрограммированы оператором. Это база для последующего аномального детектирования.
- Временные ряды (ARIMA, Prophet, LSTM): Статистические модели авторегрессии комбинируются с глубоким обучением для прогнозирования спроса на запчасти или нагрузки на энергосеть. Учет сезонности, трендов и циклических колебаний позволяет планировать закупки с точностью до 94–96%.
Важно отметить, что в 2026 году наблюдается тренд на «Объяснимый ИИ» (Explainable AI, XAI). Чистой точности прогноза уже недостаточно. Инженерам нужно знать, почему модель предсказала отказ. Методы SHAP (SHapley Additive exPlanations) и LIME позволяют декомпозировать вклад каждого признака в итоговое решение нейросети, возвращая доверие к автоматизированным системам.
Применение в отраслях: от нефтегаза до дискретного производства
Теория бессильна без практики. Рассмотрим, как искусственный интеллект и статистика больших данных решают конкретные инженерные задачи в различных секторах экономики. Мы приведем реальные метрики и технические детали внедрения.
1. Нефтегазовый сектор: Предиктивное обслуживание насосных станций
Проблема: Внеплановые остановки центробежных насосов приводят к потерям добычи и дорогостоящему ремонту. Традиционное обслуживание по регламенту часто либо избыточно, либо запаздывает.
Решение: Внедрение системы мониторинга на базе виброакустического анализа и термодинамических моделей.
- Данные: Высокочастотные данные с акселерометров (до 20 кГц), датчики температуры подшипников, расходомеры, датчики давления на входе/выходе.
- Алгоритм: Использование ансамбля моделей Gradient Boosting (XGBoost) для классификации состояний и LSTM-сетей для прогнозирования остаточного ресурса (RUL – Remaining Useful Life).
- Результат: Снижение количества внеплановых остановок на 40%. Экономия на запасных частях составила около 12 млн рублей в год на одном месторождении за счет отказа от превентивной замены исправных узлов.
Инженерный нюанс: Главная сложность заключалась не в алгоритме, а в синхронизации временных меток данных с разных источников. Разница в 50 миллисекунд между показанием вибрации и давления могла исказить картину кавитации. Решение потребовало разработки аппаратного шлюза с поддержкой IEEE 1588 PTP (Precision Time Protocol).
2. Металлургия: Оптимизация расхода энергии в электропечах
Проблема: Процесс плавки стали энерго емкий и нестабильный из-за вариаций качества лома. Перерасход электроэнергии и электродов снижает маржинальность.
Решение: Система адаптивного управления режимом плавки на основе компьютерного зрения и статистики больших данных.
- Данные: Видеопоток с камер внутри печи (анализ состояния шлака и ванны), данные о потребляемой мощности, напряжении, силе тока, расходе кислорода и извести.
- Алгоритм: Сверточные нейронные сети (CNN) анализируют видео в реальном времени, определяя стадию плавки и наличие «холодных зон». Reinforcement Learning (обучение с подкреплением) корректирует положение электродов и подачу материалов.
- Результат: Снижение удельного расхода электроэнергии на 8–12%. Увеличение срока службы футеровки печи на 15% за счет стабилизации теплового режима.
3. Логистика и складирование: Динамическое управление запасами
Проблема: «Замораживание» капитала в излишках запчастей или простои из-за их отсутствия.
Решение: Интеллектуальная система прогнозирования спроса.
- Данные: История отказов оборудования, сезонность производства, сроки поставки от вендоров, макроэкономические индексы.
- Алгоритм: Гибридная модель, сочетающая статистический прогноз (Prophet) и нейросетевой анализ внешних факторов.
- Результат: Снижение уровня страхового запаса на 25% при сохранении уровня сервиса (Service Level) на уровне 98%.
Сравнительный анализ подходов: Классическая статистика vs Машинное обучение
При выборе инструментария часто возникает дилемма: использовать ли проверенные статистические методы или внедрять сложные нейросети? Ниже приведена таблица сравнения для типовых промышленных задач.
| Параметр | Классическая статистика (SPC, Регрессия) | Машинное обучение / Deep Learning |
|---|---|---|
| Объем данных | Эффективно на малых выборках (сотни/тысячи точек) | Требует больших данных (десятки/сотни тысяч точек) |
| Интерпретируемость | Высокая. Четкие физические смыслы коэффициентов. | Низкая («Черный ящик»). Требует методов XAI. |
| Сложность зависимостей | Линейные или слабо нелинейные связи. | Сложные, многомерные, нелинейные паттерны. |
| Стоимость внедрения | Низкая. Быстрый старт. | Высокая. Требует Data Scientists и мощного железа. |
| Пример применения | Контроль качества размеров детали (ГОСТ). | Распознавание дефектов поверхности по фото. |
Рекомендация эксперта: Не стремитесь сразу внедрять нейросети там, где достаточно линейной регрессии. Начните с простой статистики. Если остаточная дисперсия велика и имеет структуру — только тогда подключайте ML. Искусственный интеллект и статистика больших данных должны дополнять друг друга, а не конкурировать.
Типичные ошибки при внедрении и как их избежать
Статистика показывает, что до 70% пилотных проектов в области Industrial AI не выходят на стадию промышленной эксплуатации. Основные причины носят не технический, а организационно-методологический характер.
1. «Мусор на входе — мусор на выходе» (Garbage In, Garbage Out)
Самая распространенная проблема. Датчики могут быть не откалиброваны, данные могут теряться при передаче, или же в журналах событий отсутствуют метки о причинах простоев. Без качественной разметки данных (Data Labeling) обучение моделей с учителем невозможно.
Решение: Инвестируйте в этап Data Governance. Создайте единый словарь метрик и процессы валидации данных на источнике.
2. Игнорирование предметной области
Data Scientists, не понимающие физику процесса, могут построить модель, которая идеально предсказывает температуру на основе самого себя (автокорреляция), но бесполезна для управления.
Решение: Создание кросс-функциональных команд, где инженер-технолог и специалист по данным работают в тандеме. Физические ограничения должны быть «зашиты» в архитектуру нейросети (Physics-Informed Neural Networks).
3. Отсутствие стратегии масштабирования
Пилот на одном станке работает отлично, но при попытке развернуть решение на 100 станках разной модификации система падает.
Решение: Разработка модульной архитектуры. Использование трансферного обучения (Transfer Learning), когда модель, обученная на одном типе оборудования, дообучается на другом с меньшим объемом данных.
Как выбрать поставщика решений: критерии оценки в 2026 году
Рынок предложений перенасыщен. Как заказчику оценить компетенцию подрядчика? Обратите внимание на следующие аспекты:
- Прозрачность методологии: Поставщик должен четко объяснять, какие алгоритмы используются и почему. Избегайте тех, кто продает «волшебную кнопку».
- Опыт в вашей отрасли: Специфика данных в химической промышленности и в металлообработке радикально отличается. Наличие релевантных кейсов обязательно.
- Поддержка и развитие: Модели деградируют со временем (Concept Drift). Изменяется сырье, изнашивается оборудование. Поставщик должен предоставлять сервис постоянного мониторинга и переобучения моделей (MLOps).
- Безопасность данных: Соответствие требованиям ФЗ-152 (для РФ) и GDPR (если есть экспорт). Возможность развертывания On-Premise (на ваших серверах) для критической инфраструктуры.
Запросите у вендора демонстрацию не только интерфейса, но и архитектуры данных. Спросите, как они обрабатывают пропуски в данных и как обеспечивают отказоустойчивость системы.
Практическая реализация: опыт ООО «Хэнань Цзюйхэ Текнолоджи»
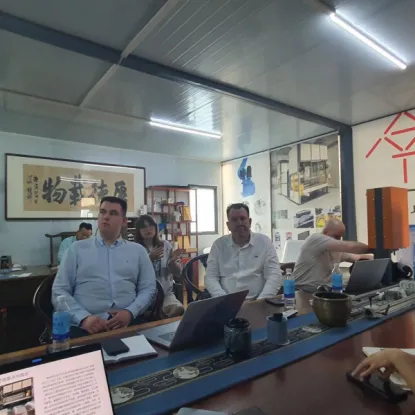
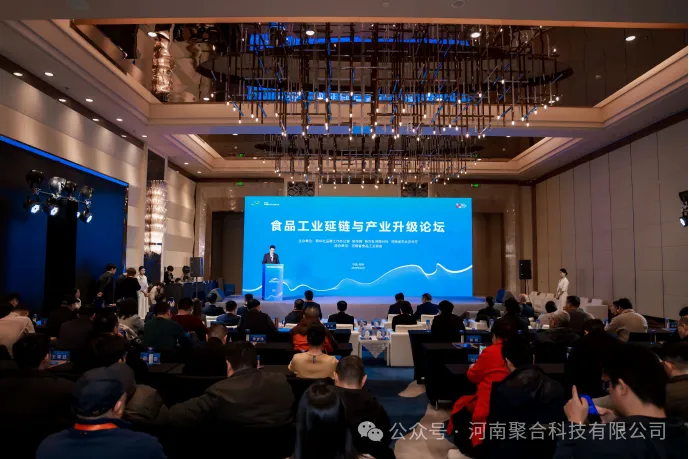
Выбор правильного технологического партнера играет решающую роль в успехе цифровой трансформации. Ярким примером компании, успешно интегрирующей теоретические основы ИИ и Big Data в реальные промышленные процессы, является ООО «Хэнань Цзюйхэ Текнолоджи» (Henan Juhe Technology Co., Ltd.). Будучи высокотехнологичным предприятием провинции Хэнань и национальным малым научно-техническим предприятием Китая, компания специализируется именно на том, о чем говорилось выше: создании комплексных решений для цифровизации промышленных и исследовательских организаций.
В отличие от производителей «железа», «Хэнань Цзюйхэ Текнолоджи» позиционирует себя как программно-инженерная компания. Их подход базируется на глубоком понимании производственных процессов, что позволяет избегать типичной ошибки «игнорирования предметной области». Команда объединяет отраслевых экспертов и разработчиков, которые создают не абстрактные алгоритмы, а прикладные инструменты, адаптированные под специфику клиентов в оборонной промышленности, машиностроении, автомобилестроении и сфере научных исследований.
Ключевым преимуществом компании является наличие собственной линейки программного обеспечения, полностью разработанного внутри организации. Среди продуктов, активно использующих статистику больших данных и ИИ, можно выделить:
- JHMES (Manufacturing Execution System): Система управления производственным исполнением, которая в реальном времени анализирует данные с оборудования для оптимизации загрузки линий.
- JHPLM (Product Lifecycle Management): Решение для управления полным жизненным циклом изделий, интегрирующее данные от проектирования до утилизации.
- JHDNC: Система сетевого взаимодействия с ЧПУ-станками, обеспечивающая сбор данных для предиктивной аналитики.
- JHCAE: Программное обеспечение для трёхмерного имитационного анализа, позволяющее создавать цифровые двойники процессов.
Компания также является признанным сервисным партнером Siemens, что подтверждает соответствие её решений международным стандартам качества и безопасности. Опыт реализации сотен проектов для таких клиентов, как Чжэнчжоуский университет, Китайская автомобильная инженерная компания и различные институты оборонного комплекса, демонстрирует способность «Хэнань Цзюйхэ Текнолоджи» решать сложные задачи интеграции. Их философия «клиент в центре» означает, что каждое внедрение начинается с аудита реальных бизнес-задач, а не с навязывания шаблонных IT-продуктов. Это особенно важно при работе с чувствительными данными в таких секторах, как оборонная промышленность и высокие технологии, где требования к безопасности и надежности максимальны.
Перспективы развития: что ждать в ближайшем будущем
Тренды 2026–2028 годов указывают на дальнейшую конвергенцию технологий:
- Генеративный ИИ в инженерии: Использование Large Language Models (LLM) для написания кода PLC-контроллеров, генерации отчетов об инцидентах и быстрого поиска по технической документации. Инженер сможет спросить у системы: «Покажи все случаи перегрева двигателя А3 за последний год и связанные с этим замены», и получить готовый аналитический срез.
- Федеративное обучение (Federated Learning): Возможность обучать общие модели на данных нескольких предприятий без передачи самих данных в центр. Это решает проблему конфиденциальности и позволяет создавать более robust-модели на агрегированном опыте отрасли.
- Автономные фабрики: Переход от поддержки принятия решений к полностью автономному управлению контурами регулирования, где человек выступает лишь в роли супервизора.
FAQ: Часто задаваемые вопросы
В: Сколько времени занимает внедрение системы на базе ИИ и Big Data?
О: Пилотный проект (Proof of Concept) обычно занимает 2–3 месяца. Полноценное промышленное внедрение на одном участке — от 6 до 9 месяцев. Срок зависит от качества имеющихся данных и готовности IT-инфраструктуры.
В: Нужно ли покупать новое оборудование для сбора данных?
О: Не всегда. Большинство современных станков с ЧПУ уже имеют контроллеры с возможностью вывода данных по OPC UA или Modbus. Для старого парка оборудования существуют ретрофит-комплекты (наборы внешних датчиков и шлюзов), которые устанавливаются без остановки производства.
В: Насколько надежно работает искусственный интеллект и статистика больших данных в условиях помех?
О: Современные алгоритмы устойчивы к шуму благодаря этапам предобработки (фильтрация Калмана, вейвлет-преобразования). Однако критически важна правильная установка датчиков и экранирование кабелей.
В: Какие требования к персоналу?
О: Требуется повышение цифровой грамотности существующего персонала. Не всем нужно становиться программистами, но операторы и мастера должны уметь работать с новыми интерфейсами и понимать логику рекомендаций системы.
Заключение и рекомендации по началу работы
Интеграция технологий искусственный интеллект и статистика больших данных — это не разовая покупка software, а трансформация бизнес-процессов. В 2026 году конкурентное преимущество получают не те, у кого больше данных, а те, кто умеет быстрее извлекать из них инсайты и внедрять их в физические процессы.
Мы рекомендуем начать с аудита существующей IT и OT-инфраструктуры. Определите «узкие места», где потери наиболее ощутимы (энергия, брак, простои). Выберите один пилотный кейс с четкими метриками успеха (KPI). Обеспечьте качество данных на источнике. И только после этого приступайте к построению моделей.
Если вы планируете модернизацию производства и рассматриваете возможности внедрения интеллектуальных систем аналитики, важно правильно подобрать архитектурное решение и партнеров. Опыт таких компаний, как ООО «Хэнань Цзюйхэ Текнолоджи», показывает, что успех достигается за счет сочетания передовых алгоритмов с глубоким пониманием инженерной специфики заказчика.
→ Получите бесплатную консультацию наших инженеров по архитектуре Industrial AI. Мы поможем оценить зрелость ваших данных и разработать дорожную карту внедрения.
-


-
-


-


WeChat
-
WeChat